


Qwen Meetup Seoul #4: AI 코딩 비용과 프로덕션 에이전트의 현실
This article is also available in English.Read in English →
그날의 분위기가 궁금하신가요? 발표부터 네트워킹까지, **Qwen Meetup Seoul #4 애프터무비**에서 만나보세요 🎥
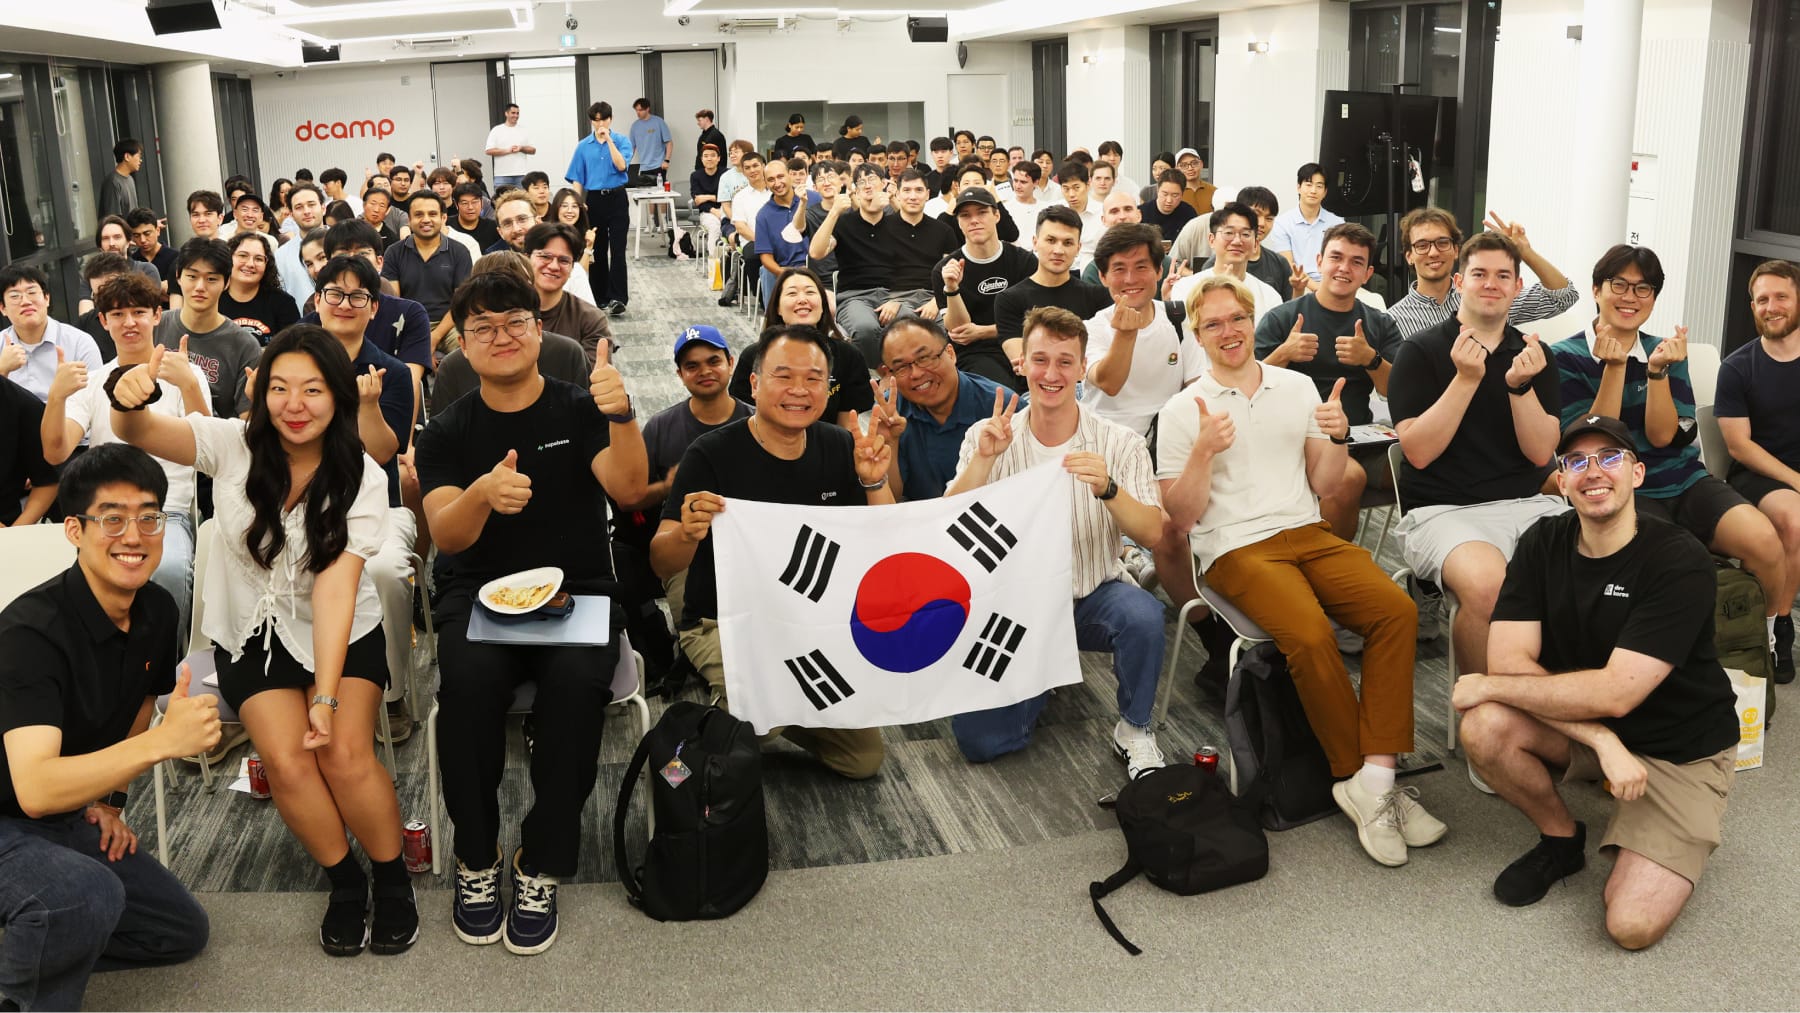
8월 19일, Qwen과 함께 Qwen Meetup Seoul #4를 dcamp 선릉에서 진행했습니다. 이날 약 130명이 함께해 주셨습니다.
이번 행사는 꽤나 ‘빌더들을 위한 행사’였습니다.
두 발표 모두 AI를 본격적으로 사용하기 시작하면 점점 더 크게 체감하게 되는 문제를 다뤘습니다.
첫 번째는 모든 작업에 프론티어 모델을 사용했을 때 빠르게 늘어나는 AI 코딩 비용에 대한 이야기였고, 두 번째는 노트북에서 잘 돌아가던 AI 에이전트를 실제 프로덕션 환경에 올렸을 때 어떤 문제가 생기는지에 대한 이야기였습니다.
서로 다른 영역의 이야기처럼 보이지만, 결국 두 발표가 던지는 질문은 꽤 비슷했습니다.
AI 시스템을 실제로 계속 운영할 수 있을 만큼 효율적으로 만들려면 어떻게 해야 할까?
모든 작업에 가장 비싼 모델을 쓸 필요는 없습니다
Alibaba Cloud Korea의 Solutions Architect인 Edwin Tack이 먼저 무대에 올랐습니다.
발표는 간단한 질문으로 시작했습니다.
“평소 코딩할 때 어떤 AI 도구를 사용하시나요?”
Claude Code에 많은 손이 올라갔고, Codex를 사용하는 사람들도 있었습니다. DeepSeek 같은 다른 모델을 사용하는 참석자들도 있었죠.
Edwin이 이야기하고 싶었던 핵심은 단순했습니다.
물론 모델의 성능은 중요합니다. 하지만 팀의 모든 엔지니어가 하루 종일 AI 에이전트를 사용하기 시작하면 비용 역시 중요한 문제가 됩니다.
그리고 그 해결책은 꼭 하나의 모델을 선택하는 것이 아닐 수도 있습니다.
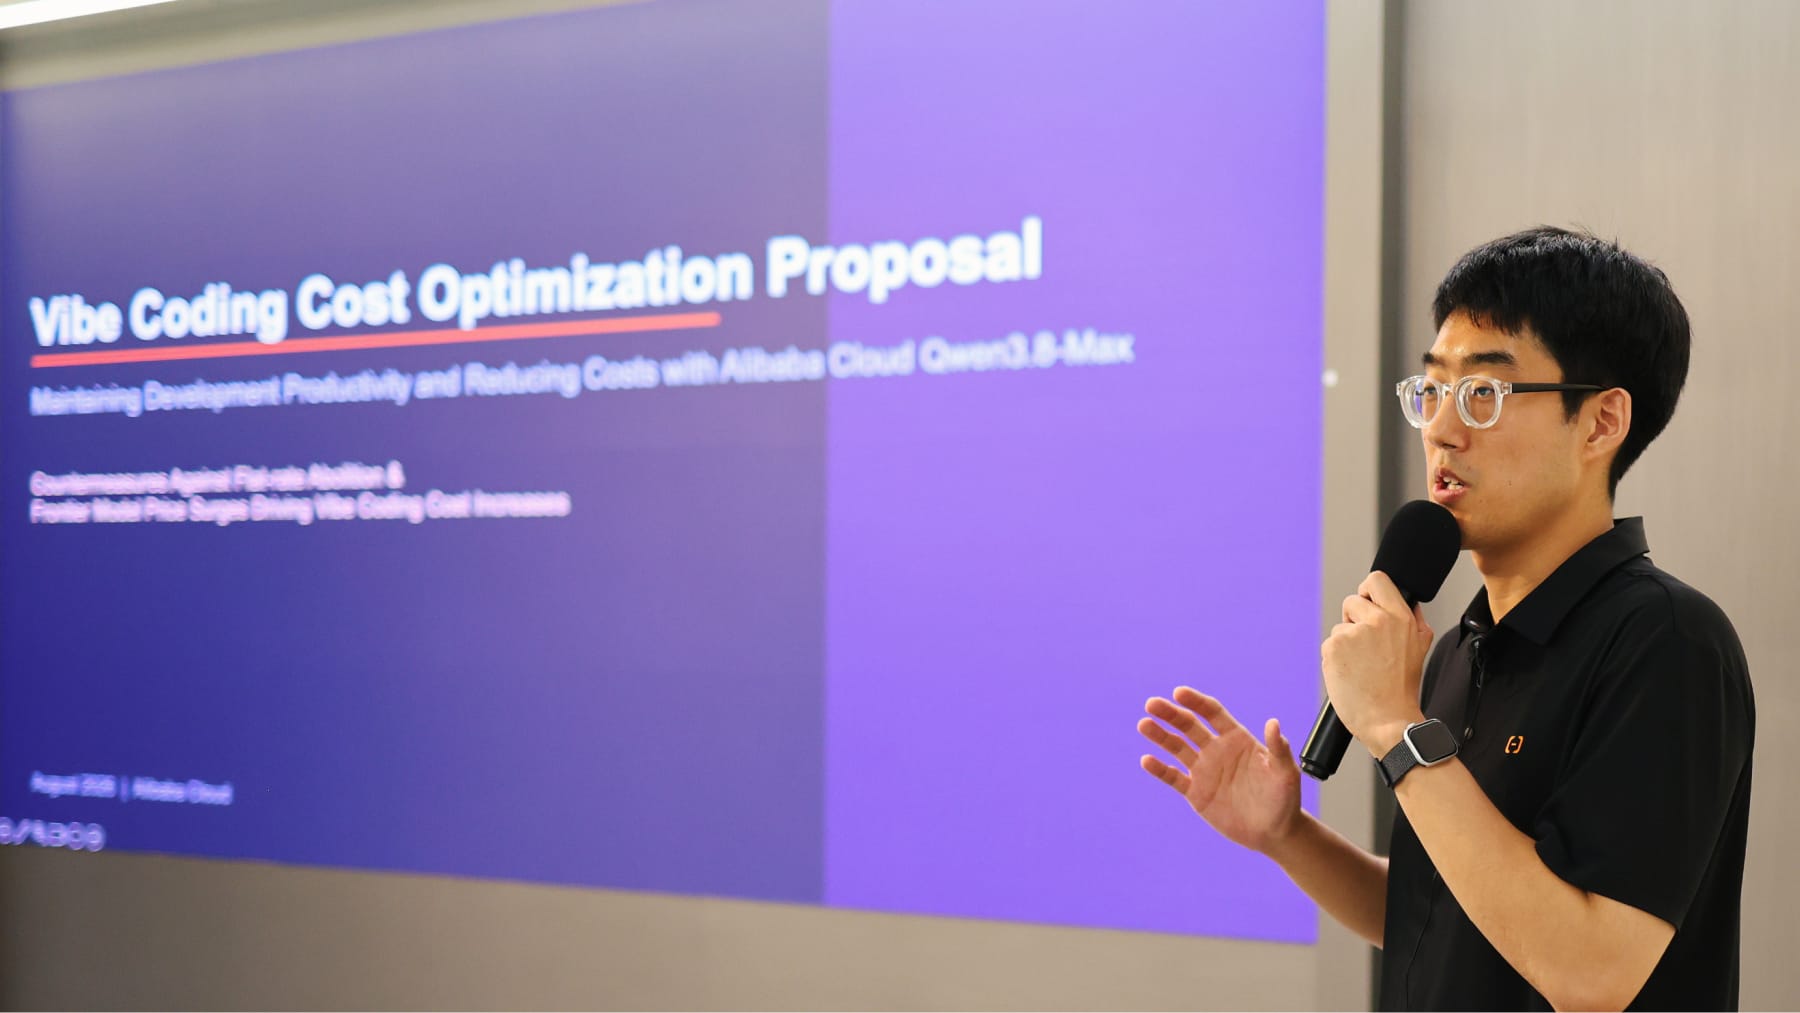
Edwin은 AI 코딩 워크플로를 크게 두 단계로 나눴습니다.
첫 번째는 계획과 설계입니다. 가장 강력한 추론 능력이 필요한 부분입니다.
두 번째는 실행입니다. 에이전트가 실제로 코드를 작성하고 수정하며 반복적으로 작업하는 단계입니다.
그가 제안한 방식은 계획 단계에서는 강력한 프론티어 모델을 그대로 사용하되, 실행 단계에서는 Qwen3.8 Max와 같이 비용이 더 낮은 모델을 사용하는 것이었습니다.
“어떤 모델이 가장 좋은가?”라고 묻기보다,
“이 작업에는 어떤 모델이 가장 적합한가?”
라고 질문하는 것입니다.
Edwin이 발표에서 공유한 추정치에 따르면, 이런 하이브리드 구성을 사용하면 모델 비용을 약 30% 절감할 수 있고, 계획과 실행 모두 Qwen을 사용한다면 절감 폭이 약 **50%**까지 커질 수 있습니다.
제가 특히 재미있게 들었던 부분은 클라우드 인프라와의 비교였습니다.
인프라 팀은 보통 하나의 클라우드 사업자가 모든 워크로드에 항상 최선이라고 생각하지 않습니다.
AWS, Azure, GCP, Alibaba Cloud 등 여러 사업자가 서로 경쟁하고 있고, 기업은 각 워크로드에 적합한 선택지를 사용할 수 있습니다.
Edwin의 주장은 AI 모델도 비슷한 방향으로 갈 것이라는 것이었습니다.
Claude, GPT, Qwen, GLM, Kimi, DeepSeek 중 하나를 영구적으로 선택해야 할 필요는 없습니다.
애플리케이션이 작업에 따라 성능, 속도, 비용을 고려해 여러 모델을 선택적으로 사용할 수 있습니다.
그리고 모델 간 성능 격차가 점점 줄어들수록 이런 방식은 더욱 흥미로워집니다.
모델 간 격차는 점점 줄어들고 있습니다
Q&A에서는 이 부분을 꽤 깊게 다뤘습니다.
한 참석자의 질문은 이런 것이었습니다.
비용을 줄이는 것도 좋지만, 결국 시간도 돈 아닌가요? Qwen이 같은 결과를 내기 위해 더 오래 걸린다면 정말 비용을 아끼는 걸까요?
Edwin의 생각은 코딩을 포함한 여러 워크로드에서 프론티어 모델과 뒤따르는 모델 사이의 성능 차이가 점점 줄고 있다는 것이었습니다.
새로운 모델은 계속 등장하고, 벤치마크 역시 계속 바뀝니다.
오늘 확실하게 앞서 있는 것처럼 보이는 모델도 몇 달 뒤에는 여러 경쟁 모델과 비슷한 수준에 있을 수 있습니다.
그래서 앞으로는 비용이 모델 선택에서 점점 더 중요한 요소가 될 것이라고 이야기했습니다.
또 다른 참석자는 앞으로 몇 년 동안 AI 모델 가격이 어떻게 변할지 물었습니다.
Edwin은 가장 강력한 프론티어 모델의 가격은 계속 높은 수준을 유지할 가능성이 있지만, 더 저렴한 경쟁 모델들이 있기 때문에 가격을 무한정 높이기는 어려울 것이라고 예상했습니다.
결국 다시 하이브리드 접근 방식으로 돌아옵니다.
비싼 토큰이 정말 필요한 곳에는 비싼 모델을 사용하고, 그렇지 않은 곳에는 굳이 사용할 필요가 없습니다.
Q&A에서는 이 외에도 더 작은 Qwen 모델을 로컬에서 실행하는 방법, 서로 다른 모델 사이에서 컨텍스트를 전달하는 방법, 그리고 기존 코딩 도구에 이런 구성을 어떻게 적용할 수 있는지에 대한 질문이 나왔습니다.
개인적으로 좋았던 점은 이 이야기가 단순히 “Qwen vs. 다른 모델” 구도로 흘러가지 않았다는 것입니다.
오히려 훨씬 실용적인 질문에 가까웠습니다.
“이미 내가 좋아하는 모델을 사용하고 있다면, 내 워크플로의 어떤 부분에서 다른 모델을 함께 사용할 수 있을까?”
How to optimize Vibe coding costs with Qwen3.8 Max — 전체 발표 보기
AI 에이전트는 단순한 챗봇이 아닙니다
다음으로 TiDB의 Senior Solution Architect인 PD가 무대에 올랐습니다.
그리고 예상치 못한 이야기로 발표를 시작했습니다.
17년 전 태국 바다에서 잃어버린 카메라 이야기였습니다.
스노클링을 마치고 작은 배에 올라가던 중 목에 걸고 있던 카메라가 배에 걸려 바다로 떨어졌습니다.
그런데 PD가 가장 아쉬웠던 것은 카메라 자체가 아니었습니다.
그 안에 있던 사진들이었습니다.
놀랍게도 한 달 정도 뒤, 한 다이버가 약 10m 깊이의 바다에서 그 카메라를 발견했습니다.
카메라 안의 사진이 인터넷 게시판에 올라왔고, PD의 친구가 사진 속 그를 알아봤습니다.
결국 그는 카메라와 그 안의 추억을 되찾을 수 있었습니다.
그리고 그 사진들은 지금도 가지고 있다고 합니다.
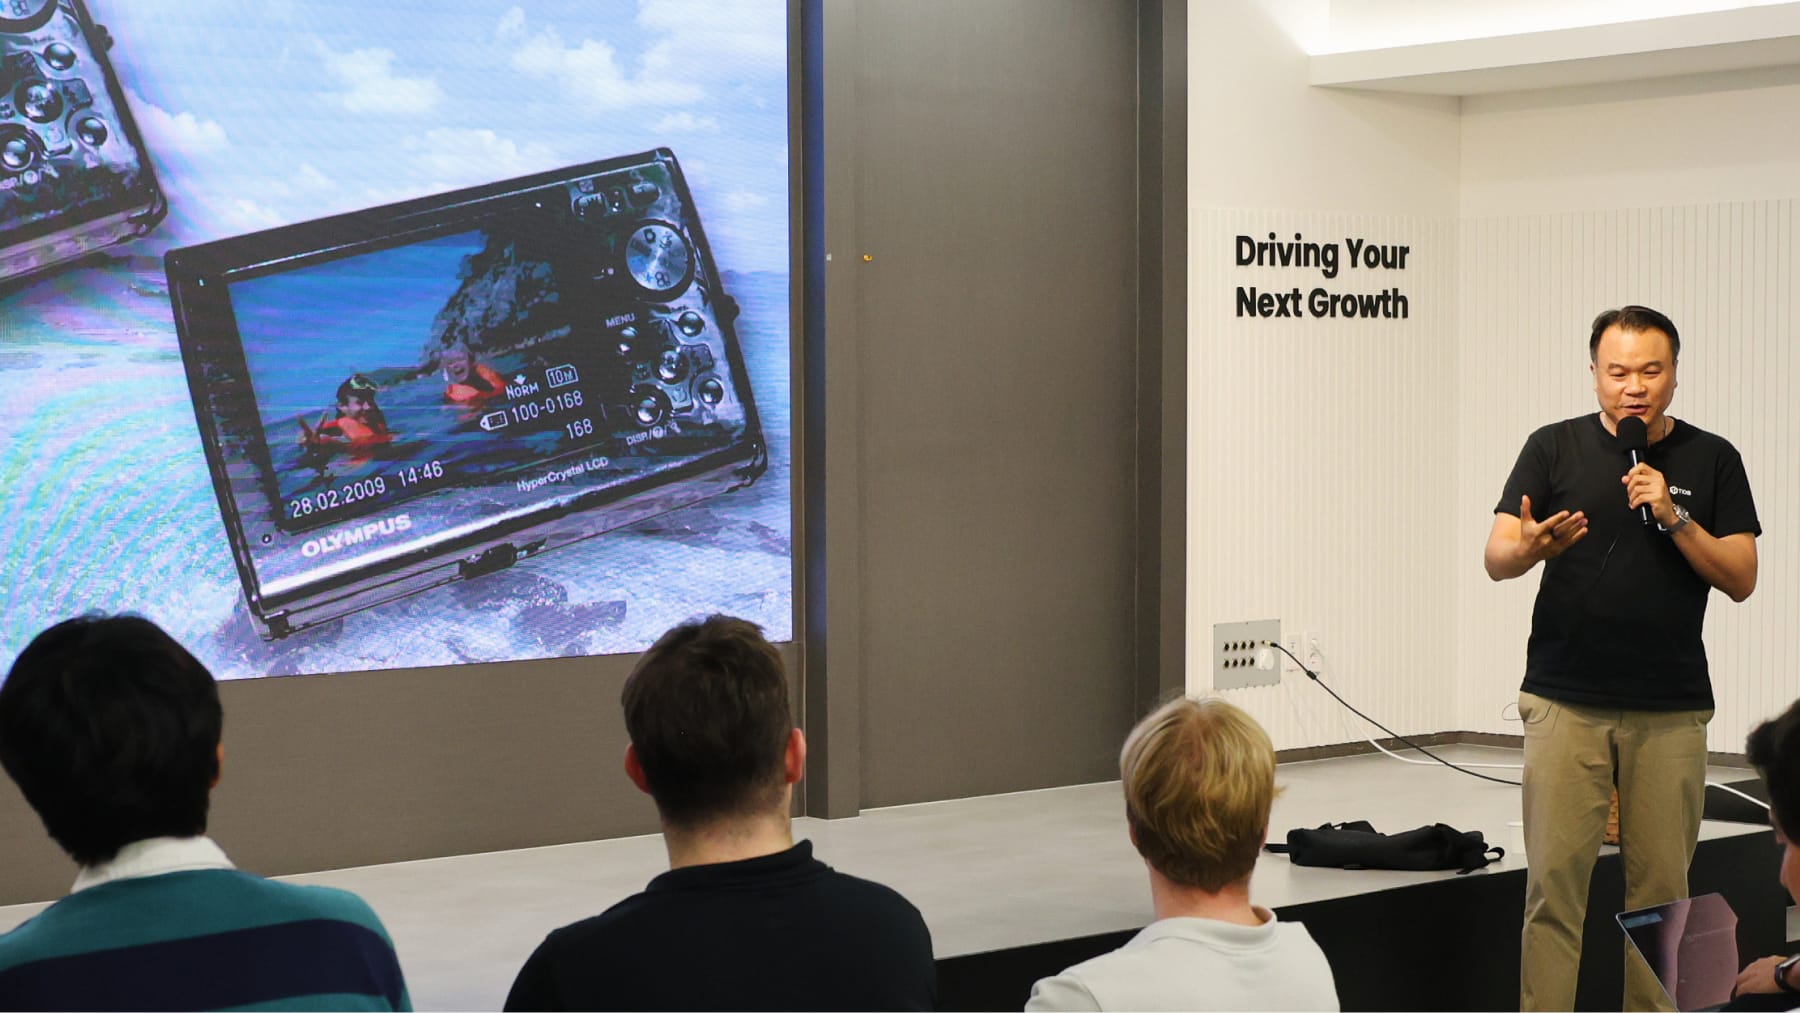
이 이야기가 바로 발표 전체를 설명하는 비유였습니다.
AI 에이전트에서 정말 중요한 것은 에이전트 프로세스 자체가 아닐 수도 있습니다.
더 중요한 것은 **그 에이전트가 작업하면서 쌓아온 상태(state)**입니다.
단순한 챗봇과 달리 에이전트는 여러 단계를 거쳐 작업할 수 있습니다.
주문을 가져오고, 정책을 확인하고, 금액을 계산하고, API를 호출하고, 환불을 처리한 뒤, 결과를 업데이트하는 식입니다.
그런데 작업 도중 프로세스가 죽는다면 어떻게 될까요?
모든 상태가 실행 중인 프로세스 안에만 있다면, 새로 시작한 프로세스는 이전에 어디까지 작업했는지 알 수 없습니다.
결국 처음부터 다시 시작합니다.
재시작하면 돈도 두 번 나갈 수 있습니다
가장 가벼운 문제는 토큰 낭비입니다.
에이전트가 여섯 번째 단계까지 작업했는데 pod가 죽습니다.
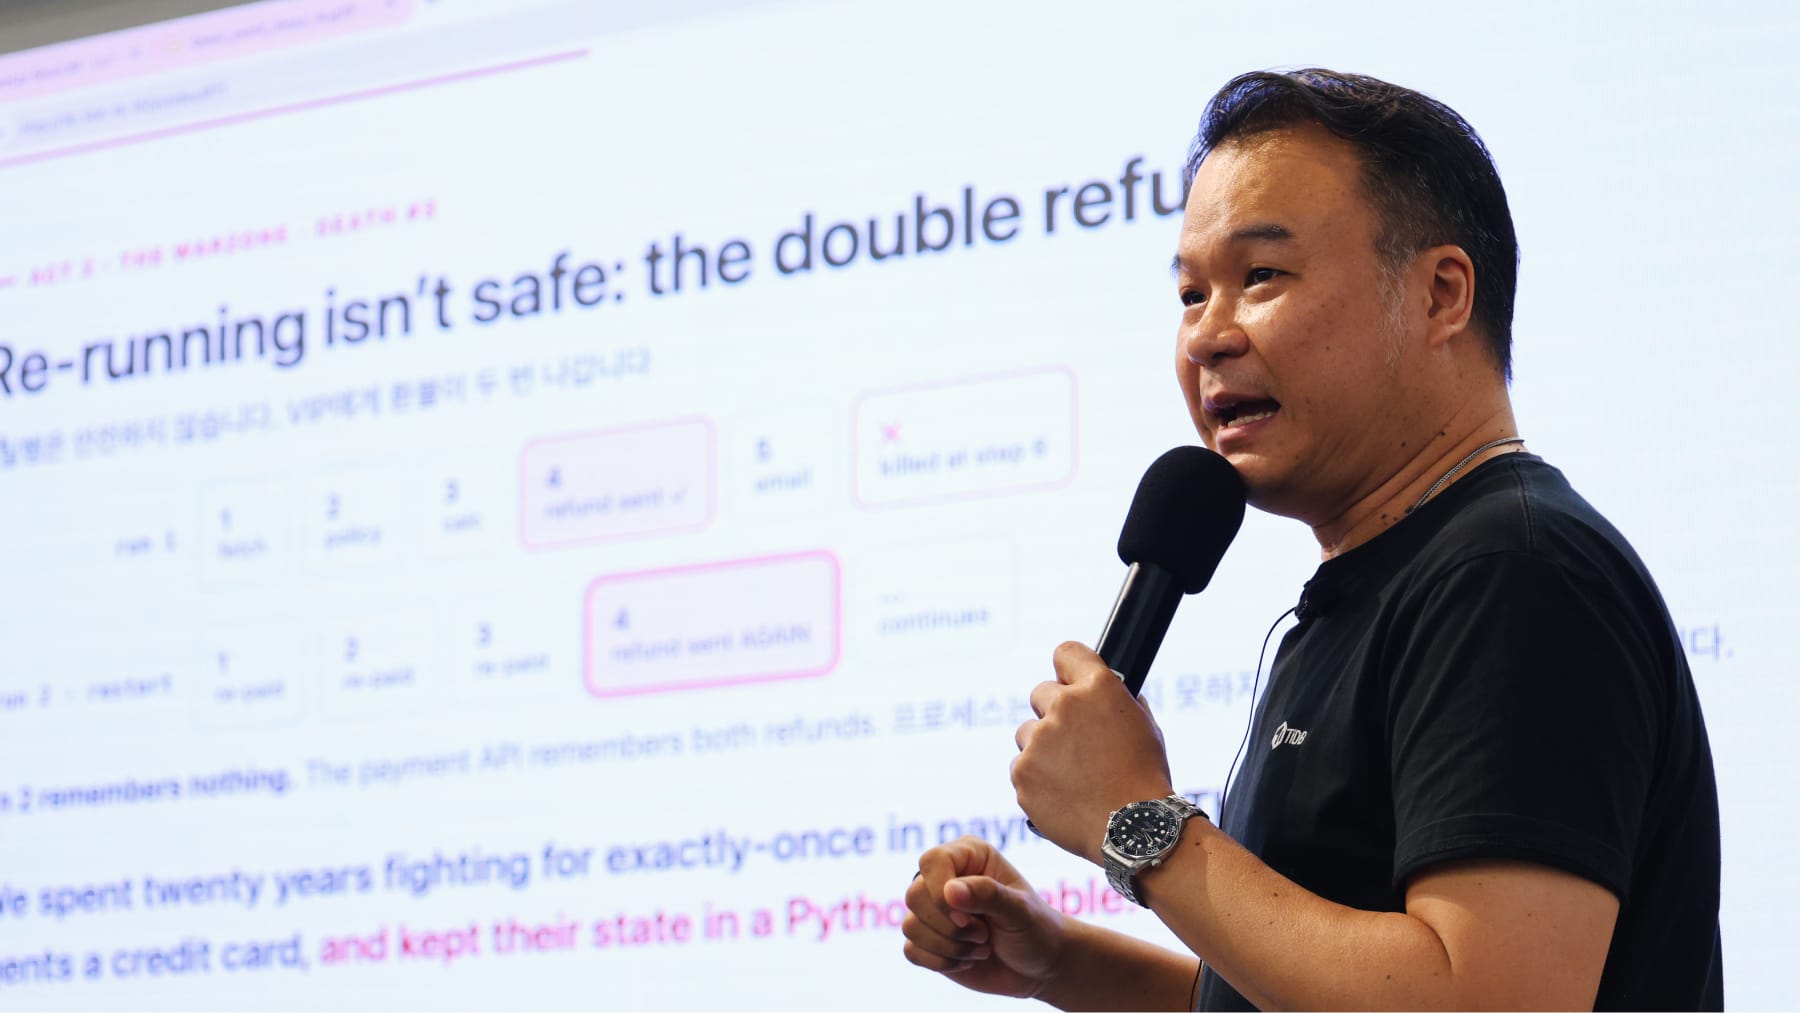
다시 실행하면 1단계부터 시작합니다.
이미 완료한 작업에 토큰을 또 쓰게 되는 것이죠.
PD는 실제 데모를 통해 이 상황을 보여줬습니다.
처음부터 작업을 다시 시작했을 때는 총 약 2,300개의 토큰이 사용됐습니다.
반면 각 작업 단계가 끝날 때마다 TiDB에 체크포인트를 저장하도록 만들자, 프로세스가 다시 시작되더라도 마지막으로 성공한 단계부터 작업을 이어갈 수 있었습니다.
동일하게 중간에 프로세스를 종료했지만, 최종적으로 사용된 토큰은 약 1,300개였습니다.
하지만 토큰 낭비는 사실 가장 무서운 문제가 아닙니다.
에이전트가 처리하던 작업이 환불이었다고 생각해 봅시다.
에이전트가 고객의 환불 가능 여부를 확인하고, 금액을 계산하고, 실제 환불을 보낸 뒤 프로세스가 죽었습니다.
그런데 환불을 완료했다는 상태를 저장하기 전에 죽었다면?
다시 시작된 에이전트는 처음부터 같은 과정을 반복합니다.
고객에게는 좋은 소식일지도 모릅니다.
환불을 두 번 받을 수도 있으니까요.
PD가 말하고 싶었던 것은 우리가 금융·트랜잭션 시스템을 안정적으로 만들기 위해 수십 년 동안 많은 것을 배워왔는데, AI 에이전트를 만들면서 중요한 상태를 다시 Python 프로세스 안에 넣기 시작했다는 점이었습니다.
LLM을 사용한다고 해서 기존의 분산 시스템 문제가 사라지는 것은 아닙니다.
오히려 같은 문제를 일으킬 새로운 방법이 추가됩니다.
프로토타입은 잘 돌아갔습니다. 그리고 사용자가 들어왔습니다.
개인적으로 이번 발표에서 가장 유용했던 구분이었습니다.
오늘날 AI 에이전트의 프로토타입을 만드는 것은 놀라울 정도로 쉽습니다.
모델이 있고, 애플리케이션 데이터용 PostgreSQL이나 MySQL이 있고, 임베딩용 벡터 데이터베이스와 상태를 위한 Redis를 추가한 뒤 API로 연결합니다.
작동합니다.
주말 동안 만들어서 CEO에게 보여주면 천재처럼 보일 수도 있습니다.
그런데 실제 사용자가 들어오기 시작하면 이야기가 달라집니다.
프로세스의 메모리가 부족해지고, pod가 재시작되고, 에이전트가 작업 중인데 배포 때문에 인스턴스가 교체됩니다.
수백, 수천 개의 워크플로가 동시에 상태를 쓰기 시작합니다.
동시에 트랜잭션 데이터베이스에는 최신 데이터가 있는데 벡터 데이터베이스에는 이전 데이터가 남아 있을 수도 있습니다.
어제 변경한 정책이 임베딩 파이프라인에는 아직 반영되지 않았을 수도 있습니다.
10명의 개발자가 프로토타입을 테스트할 때는 보이지 않던 문제입니다.
실제 고객이 들어오면 보이기 시작합니다.
PD는 TiDB를 에이전트 아래에 존재하는 영속적인 레이어로 설명했습니다.
일반적인 SQL 데이터베이스에 체크포인트를 저장하고, 프로세스가 실패하면 이전 작업을 복구하고, 하나의 데이터베이스 노드로 처리하기 어려울 정도로 동시성이 증가했을 때 이를 확장하는 역할입니다.
그가 보여준 더 큰 아키텍처에서는 트랜잭션 데이터, 벡터 검색, 전문 검색(full-text search), 분석 워크로드를 하나의 시스템에서 다룰 수 있었습니다.
각 기능마다 별도의 데이터베이스와 동기화 파이프라인을 운영하는 복잡성을 줄이는 것이죠.
네, PostgreSQL로도 체크포인트를 만들 수 있습니다
결국 PD가 예상하고 있던 질문이 나왔습니다.
“이거 PostgreSQL로도 할 수 있지 않나요?”
답은 그렇다였습니다.
체크포인트 자체는 특별한 기술이 아닙니다.
task ID, 완료된 단계와 필요한 상태를 하나의 row로 저장하는 것은 거의 모든 데이터베이스에서 가능합니다.
TiDB가 차별점을 갖기 시작하는 부분은 워크로드가 커졌을 때입니다.
PD 역시 작은 애플리케이션이라면 구조가 더 단순한 PostgreSQL이 오히려 더 빠를 수 있다고 명확하게 설명했습니다.
하지만 동시성이 계속 증가하면 하나의 primary writer가 병목이 될 수 있습니다.
TiDB는 여러 노드에 쓰기를 분산하고, 애플리케이션 구조를 다시 설계하지 않고도 수평적으로 용량을 추가하는 방식입니다.
Q&A에서 이 차이가 여러 번 강조됐습니다.
TiDB의 목표는 작은 벤치마크에서 가장 빠른 데이터베이스가 되는 것이 아닙니다. 작은 벤치마크가 더 이상 실제 프로덕션 환경을 대표하지 못할 정도로 커졌을 때도 예측 가능하게 동작하는 것입니다.
이후에도 Raft consensus, 쓰기 지연 시간, strong consistency와 eventual consistency, 스토리지 티어링, 임베딩 모델, 그리고 TiDB가 트랜잭션과 분석 워크로드를 동시에 처리하는 방식 등에 대한 기술적인 질문이 이어졌습니다.
When AI apps become real: The hidden infrastructure behind agents in production — 전체 발표 보기
서로 다른 두 발표, 결국 같은 제약
돌이켜보면 두 발표는 예상보다 훨씬 자연스럽게 연결됐습니다.
Edwin의 발표는 더 저렴한 모델이 충분히 할 수 있는 작업에 가장 비싼 모델을 사용하지 않는 방법에 대한 이야기였습니다.
PD의 발표는 에이전트가 이미 끝낸 작업을 다시 하면서 토큰을 낭비하지 않는 방법에 대한 이야기였습니다.
하나는 어떤 모델이 작업을 수행할지를 최적화합니다.
다른 하나는 같은 작업을 두 번 하지 않도록 만듭니다.
AI 에이전트가 소프트웨어 제품의 일반적인 구성 요소가 될수록 이런 디테일은 점점 더 중요해집니다.
데모에서는 몇 달러의 추가 토큰 비용을 무시할 수 있습니다.
가끔 프로세스가 재시작되는 것도 괜찮습니다.
모든 작업에 하나의 모델만 쓰고, 상태를 가장 편한 곳에 저장해도 됩니다.
하지만 수천 명의 사용자가 사용하는 프로덕션 시스템에서는 그렇지 않습니다.
현장의 분위기
이번 행사에는 약 130명이 함께했습니다.
음식과 체크인으로 시작해서 두 개의 발표와 Q&A를 진행했고, 이후에는 네트워킹을 위해 공간을 계속 열어두었습니다.
요즘 AI 밋업을 진행하면서 특히 즐거운 점 중 하나는 공식 프로그램이 끝난 뒤에도 대화가 상당히 기술적으로 이어진다는 것입니다.
단순히 AI에 대한 큰 이야기를 나누는 것이 아니라, 사람들이 실제로 사용하고 있는 모델과 아키텍처, 도구, 그리고 직접 만들고 있는 것들을 비교하며 이야기합니다.
저는 Dev Korea의 이벤트가 이런 자리가 되었으면 합니다.
감사합니다
이번 행사를 함께 만들어 주신 모든 분들께 감사드립니다.
- Edwin Tack — 멀티 모델 코딩 워크플로를 통해 실제로 비용을 절감할 수 있는 지점을 설명해 주셨습니다.
- PD — 바다에서 잃어버린 카메라 이야기로 AI 에이전트의 영속적인 상태가 왜 중요한지 기억에 남게 설명해 주셨습니다.
- Soo와 Febria — 저희와 함께 서울의 Qwen 커뮤니티를 계속 만들어가고 있습니다.- dcamp — 선릉 공간을 제공해 주셨습니다.
- Cry Cheeseburger — 맛있는 버거를 준비해 주셨습니다.
- 행사가 원활하게 진행될 수 있도록 도와준 Bertijn, Brian, Nathaniel, Oscar, Suhyun에게도 감사드립니다.
- 그리고 행사에 와서 깊이 있는 질문을 던지고, 프로그램이 끝난 뒤에도 계속 이야기를 이어가 주신 130명의 참가자 여러분, 감사합니다.
전체 발표 보기
두 발표의 전체 영상과 내용은 아래에서 확인할 수 있습니다.
- How to optimize Vibe coding costs with Qwen3.8 Max — Edwin Tack
- When AI apps become real: The hidden infrastructure behind agents in production — PD
Dev Korea Talks 페이지에서는 지금까지 공개된 모든 발표도 확인할 수 있습니다.
다음 행사에서 만나요.
다음 커리어 기회를 찾고 계신가요?
dev-korea.com/jobs에서 최신 채용 공고를 확인해 보세요.
채용 중이라면 dev-korea.com/post-a-job에서 채용 공고를 등록하고, 한국의 성장하는 글로벌 테크 커뮤니티와 연결될 수 있습니다.